联和投资公司投资企业思朗科技推出自研模型,面向分子科学的多任务推理模型达到行业SOTA
近日,联和投资公司重点投资企业思朗科技提出了一种面向分子科学的多任务推理模型,将多专家协同、化学思维链和分子知识引导的强化学习整合至统一框架。该模型覆盖分子描述与生成、化学命名转换、性质预测和反应预测等10项任务,并在47项评价指标上进行了系统验证。实验结果显示,该模型相较基础架构的综合性能提升50.3%,整体表现优于20余种通用大语言模型和分子大模型,为人工智能从“学习分子数据”走向“沿着化学逻辑完成推理”提供了新的技术路径。在思朗科技AI for Molecular Science技术布局中,该模型与面向分子动力学等科学计算任务的“天穹”3D科学计算机形成能力互补,分别从化学推理与高精度科学计算两个层面,为连接分子设计、性质预测和物理模拟提供技术支撑。
从数据驱动预测走向知识引导推理
现有分子人工智能方法主要沿着两条路线发展。一类是面向性质预测、结构生成或反应预测的专用模型,这些模型通常能够在特定任务上取得较高精度,但不同任务之间相互独立,难以支持从分子设计到实验验证的连续工作流。另一类是通用大语言模型,它们具备自然语言交互和通用推理能力,但缺乏系统的分子知识训练,在处理SMILES、分子性质和化学反应等专业问题时,容易生成不符合化学规律的内容,推理过程越长,还越可能偏离最初的正确判断。
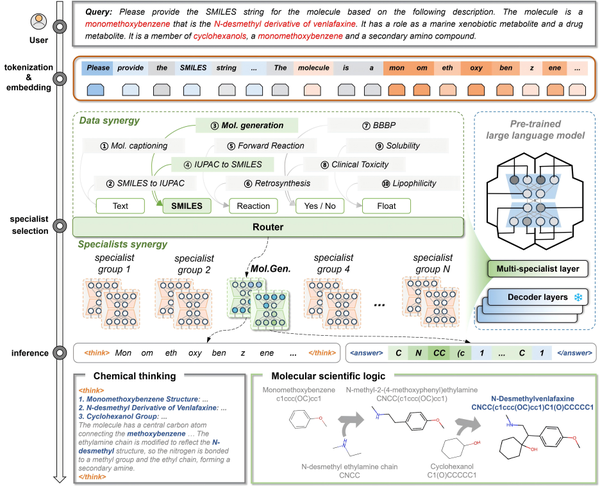
因此,分子科学大模型面临的关键问题,并不只是继续扩大参数和数据规模,而是如何同时获得准确的分子表征、面向不同任务的专业知识,以及受到化学规则约束的推理能力。基于这一认识,研究团队没有让单一模型以相同方式处理所有问题,而是构建了一套任务自适应的多专家协同框架,使模型能够根据问题类型选择相应的专业模块。
该模型共覆盖10项具有代表性的分子科学任务,包括分子描述、文本到SMILES的分子生成、SMILES与IUPAC名称双向转换、血脑屏障通透性和临床毒性分类、水溶性与亲脂性预测,以及正向反应预测和逆合成分析。虽然这些任务都以分子为研究对象,但它们所依赖的知识并不相同:分子生成关注结构有效性与目标匹配程度,性质预测需要识别结构—性质关系,反应预测则更加依赖官能团变化、反应中心和化学转化规则。
针对这种差异,模型通过任务路由器识别用户问题,并选择相应的专家组合。其中,预测专家主要负责提取分子结构信息并形成初步判断,推理专家则进一步调用化学知识,对结果进行结构化分析。两类专家协同完成任务,使模型既能保持较强的分子表征和预测能力,也能减少长推理链可能带来的错误累积。与传统混合专家模型相比,这一设计的重点并非单纯降低计算成本,而是根据不同分子任务的知识特点进行专业分工,并通过专家协同增强模型的科学推理能力。
从数据协同到分子知识对齐
高质量的分子推理数据远少于通用文本数据,简单扩大训练规模不仅成本较高,也无法保证模型真正掌握化学规律。研究团队首先从超过200万条原始数据中,根据分子特征分布进行分层采样,构建覆盖不同任务的专业指令数据。与直接汇集数据不同,这一过程强调相关任务之间的知识协同:具有相似知识基础的任务被联合训练,而知识分布差异较大的任务则交由不同专家处理,在扩大知识覆盖范围的同时减少任务之间的相互干扰。
在此基础上,研究进一步构建了面向分子科学的结构化推理监督数据,将分子结构分析、性质判断和反应推断等逻辑融入训练过程,使模型不仅学习答案是什么,也学习如何依据化学知识得到答案。这种训练策略不依赖简单堆叠大规模通用思维链,而是强调推理数据与具体分子任务、评价目标和化学约束之间的对应关系。
针对长推理过程中可能出现的答案漂移,研究团队进一步引入分子知识引导的强化学习,并为不同任务设计相应的奖励函数。例如,在分子生成任务中,模型不仅需要提高生成结构与目标要求的匹配程度,还要保证SMILES有效并满足基本化学约束;在性质和反应任务中,模型的推理过程则受到相应分子知识和任务规则的校正。通过这种知识对齐策略,模型的优化目标由“生成接近标准答案的内容”拓展为“给出准确结果,并保持推理过程的化学合理性”。
10项任务系统评估,综合性能提升50.3%
研究团队在10项分子任务和47项指标上开展了系统实验,并与20余种代表性模型进行比较,涵盖通用闭源大模型、开源大语言模型以及专门面向分子任务训练的模型。结果显示,该模型在大多数任务中取得了领先或具有竞争力的表现。相较基础模型,其综合指标由0.517提升至0.777,提高50.3%;与SOTA的分子多任务基线相比,模型在多数任务上同样表现出优势。
更值得关注的是,该模型并未依赖超大参数规模或海量推理数据,而是通过数据协同、专家分工和知识对齐提升学习效率。实验表明,相关任务之间的数据协同改善了分子知识表征,不同专家之间的专业分工减少了任务干扰,预测专家与推理专家的协作则提高了结果与推理过程的一致性。加入分子知识引导的强化学习后,模型在保持预测准确性的同时,进一步增强了结构化化学推理能力。
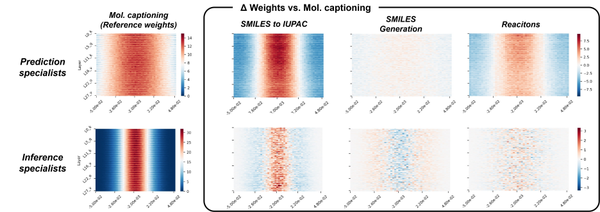
研究团队还分析了各专家模块训练前后的分子表征和权重变化。结果显示,不同专家逐渐形成了具有任务特异性的知识表达方式:预测专家更加关注结构与性质之间的稳定映射,推理专家则保留了更加丰富的分析路径。这说明模型并非对所有任务机械套用同一种推理模板,而是能够根据分子生成、性质预测和反应规划等不同问题调整分析重点。
CNS案例:连接生成、筛选、解释与合成规划
为了验证模型能否将多个分子任务组织为连续流程,研究团队进一步构建了一个中枢神经系统(CNS)候选分子设计案例。中枢神经系统候选分子的早期评价通常需要同时考虑作用机制、血脑屏障通透性、亲脂性、水溶性、潜在毒性和合成可行性,任何一个环节存在明显缺陷,都可能使候选结构失去进一步研究价值。
在该案例中,模型首先根据设计指令生成候选分子,随后预测其血脑屏障通透性、临床毒性、水溶性和亲脂性,再通过分子描述和化学命名转换解释结构特征,最后利用逆合成模块给出可能的反应物和合成思路。由此,原本需要多个独立模型完成的任务被连接为一条涵盖“设计需求、候选生成、性质筛选、结构解释和逆合成规划”的连续工作流。该概念案例在南方医科大学相关团队的医学与药理学专业支持下得到验证支持,证明该框架能够将多项分子任务组织为面向实际生物医药问题的完整分析流程。
融入AI for Molecular Science的完整技术链
这项研究最值得关注的,不只是模型在多项任务上实现了性能提升,更在于它让AI在分子科学中的角色从“完成一次预测”走向“组织一项研究”。在思朗科技AI for Molecular Science布局中,多任务分子大推理模型对应的是“理解问题、提出分子和组织任务”的能力,“天穹”3D科学计算机对应的则是“计算分子、分析行为和验证假设”的能力。前者通过任务路由和专家协同完成候选生成、性质初筛与任务规划,后者面向分子动力学等高强度科学计算,为候选分子进一步进入高精度物理模拟提供专业计算能力。一个负责把科学问题想清楚,一个负责把分子体系算清楚,两类能力共同指向同一目标:让AI生成的分子与科学假设不再停留在模型输出端,而是进入可计算、可验证的科研流程。
下一阶段,研究重点将不只是继续增加模型能够完成的任务数量,而是推动模型输出与科学计算流程衔接。研究团队将进一步增强模型对立体化学、三维构象、蛋白质—配体相互作用、反应条件和多模态实验数据的理解,并探索建立模型与分子对接、分子动力学、量子化学等计算工具之间的结构化任务接口,使模型能够将自然语言科研需求和候选分子转化为具体的计算任务,辅助完成计算方法选择、参数配置、任务组织和结果解释。
在这一过程中,多任务推理模型将逐步发展为分子研究的“任务引擎”,“天穹”3D科学计算机则为大尺度、长时间分子模拟提供“计算引擎”。随着模拟结果和外部实验验证数据不断反馈至模型,系统可以持续修正候选排序、性质判断与后续任务规划,并沉淀可复用的高质量科学数据,最终形成“推理—模拟—验证—反馈”的研究闭环。从让模型懂化学,到让机器算分子,思朗科技正在探索一条连接人工智能推理与高性能科学计算的AI for Molecular Science技术路径。